那个能通过所有检查的文件
文件安全处理流程基于一个鲜少被质疑的假设:每个文件只有一种类型。检测器为其指定类型,策略则据此进行路由。随后,每个下游引擎都会根据该类型对文件进行分析:包括反恶意软件、沙箱和净化。
多格式文件打破了这一假设。一个字节流既可以是一个完全有效的 GIF文件,同时又可以是一个完全有效的 Java 归档文件。同样的技巧也适用于既是 JPEG 文件又是 RAR 归档文件的图像,或是包含超出其逻辑结尾处的完整 ZIP 文件的 PDF 文件。每个部分单独来看都符合标准,因此任何单一的格式解析器都不会发现任何问题。
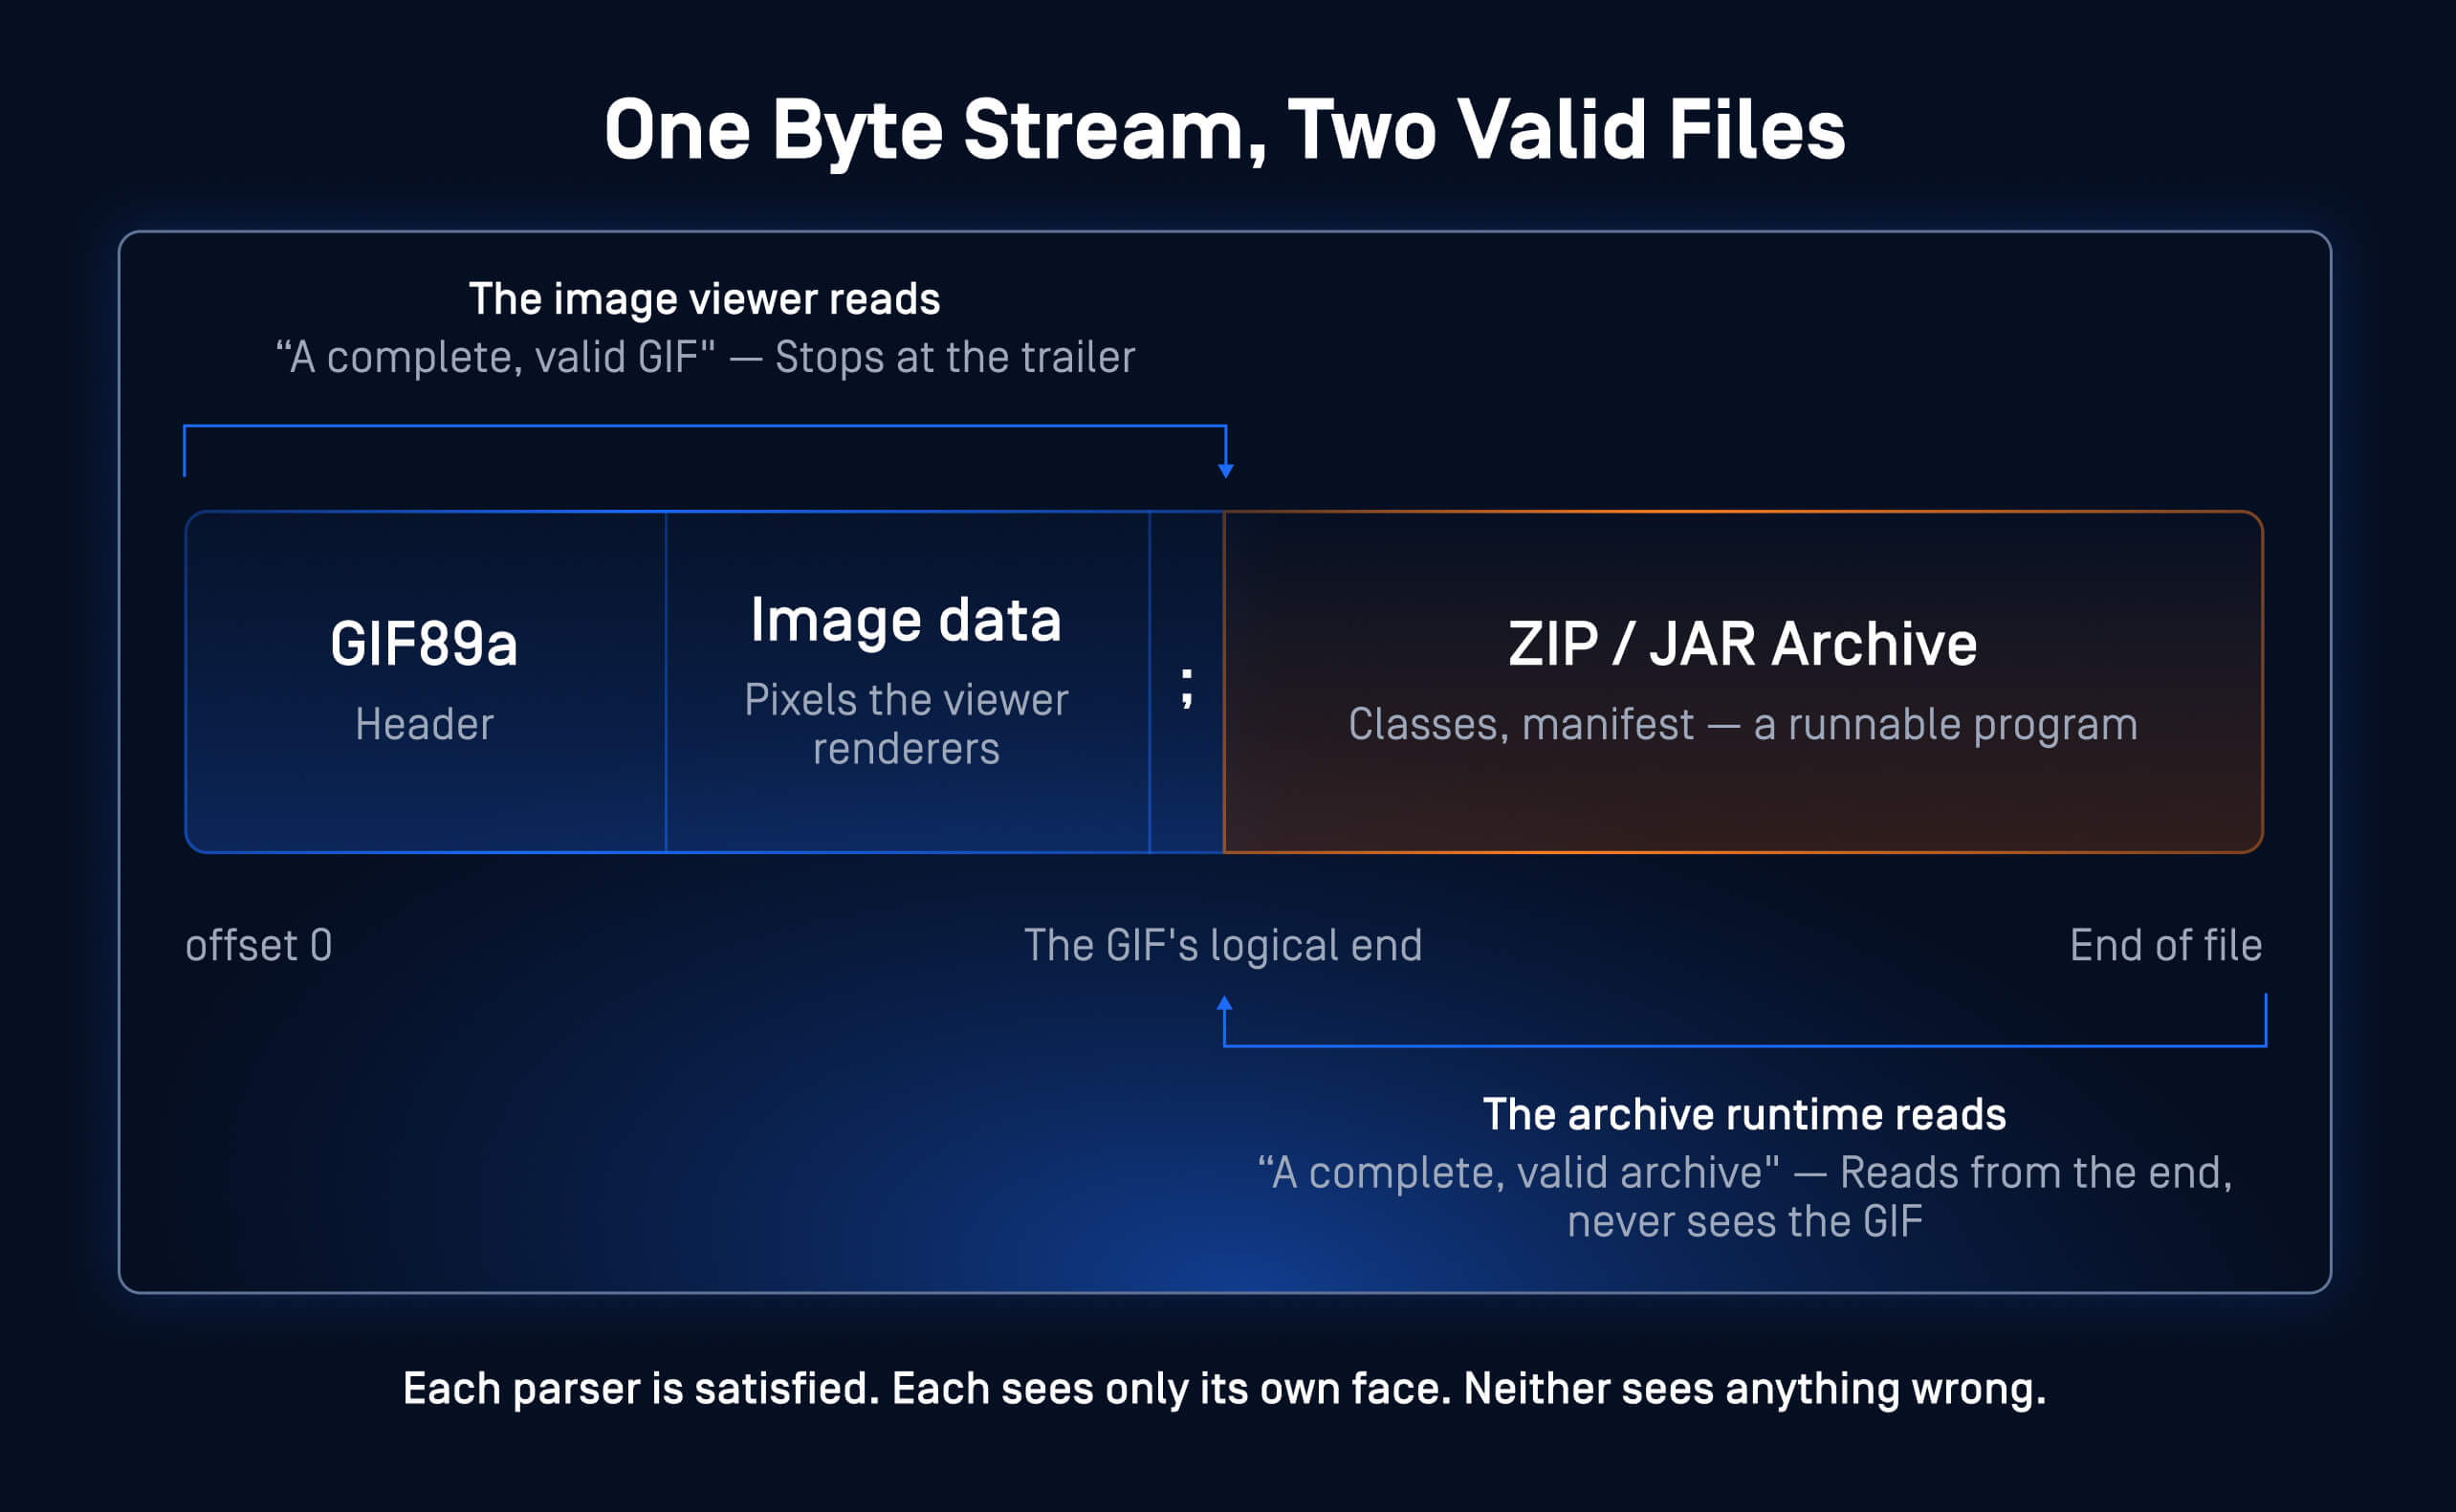
一张图片展现的多语言能力:经典的GIF+JAR格式。两个解析器、两个入口点、一个文件,且每个面都完全有效。
其安全后果非常明确:管道会将文件按其检测到的类型进行扫描,而 另一种格式则会原封不动地通过。当Web应用程序将其返回时,既是一张图片又是一段脚本的文件就会变成存储型XSS。隐藏在图片表层下的压缩包能将其有效载荷绕过内容过滤器。基于这一思路构建的攻击链——从经典的GIF+JAR组合到借助隐写术的漏洞利用传递——已公开近二十年。 反恶意软件引擎对这些攻击依然大多视而不见,因为每张图片在单独检查时都是无害的。
引擎如何找到第二张面孔
我们的文件结构验证引擎将多语言检测作为预处理步骤,在任何格式处理器运行之前,对每个扫描文件进行处理。该设计基于三个核心理念。
- 扫描整个数据流。扫描器会将整个文件与一组格式魔术签名列表进行比对。即使文件已被检测出类型,只要数据流中任何位置出现第二种格式,系统也会将其精确偏移量显示出来。这包括附加在PDF文件末尾标记之后,或隐藏在图像像素数据背后的签名。
- 明确格式合法结束的位置。 Container 等格式在技术上允许在内部包含其他文件。ZIP文件中的图像属于普通内容。检测器通过容器自身的结构来确定每个容器的真实结束位置。PDF文件的尾部、ZIP文件的核心目录以及OLE(对象链接与嵌入)复合文件的扇区分配,都标志着这一边界。PDF解析机制会考虑增量更新。 只有位于该结构之外的签名才被视为第二面。正是这一结构边界,将真正的多格式判定与针对每个普通归档文件的误报区分开来。
- 指责之前请先确认。引擎会从数据流中提取每个候选片段,并在上报前通过我们的文件类型引擎对其进行独立识别。被识别为非结构化数据的候选片段将被剔除。判定结果意味着在该偏移量处确实存在另一种格式。仅凭零散的魔术字节绝不会产生这种结果。
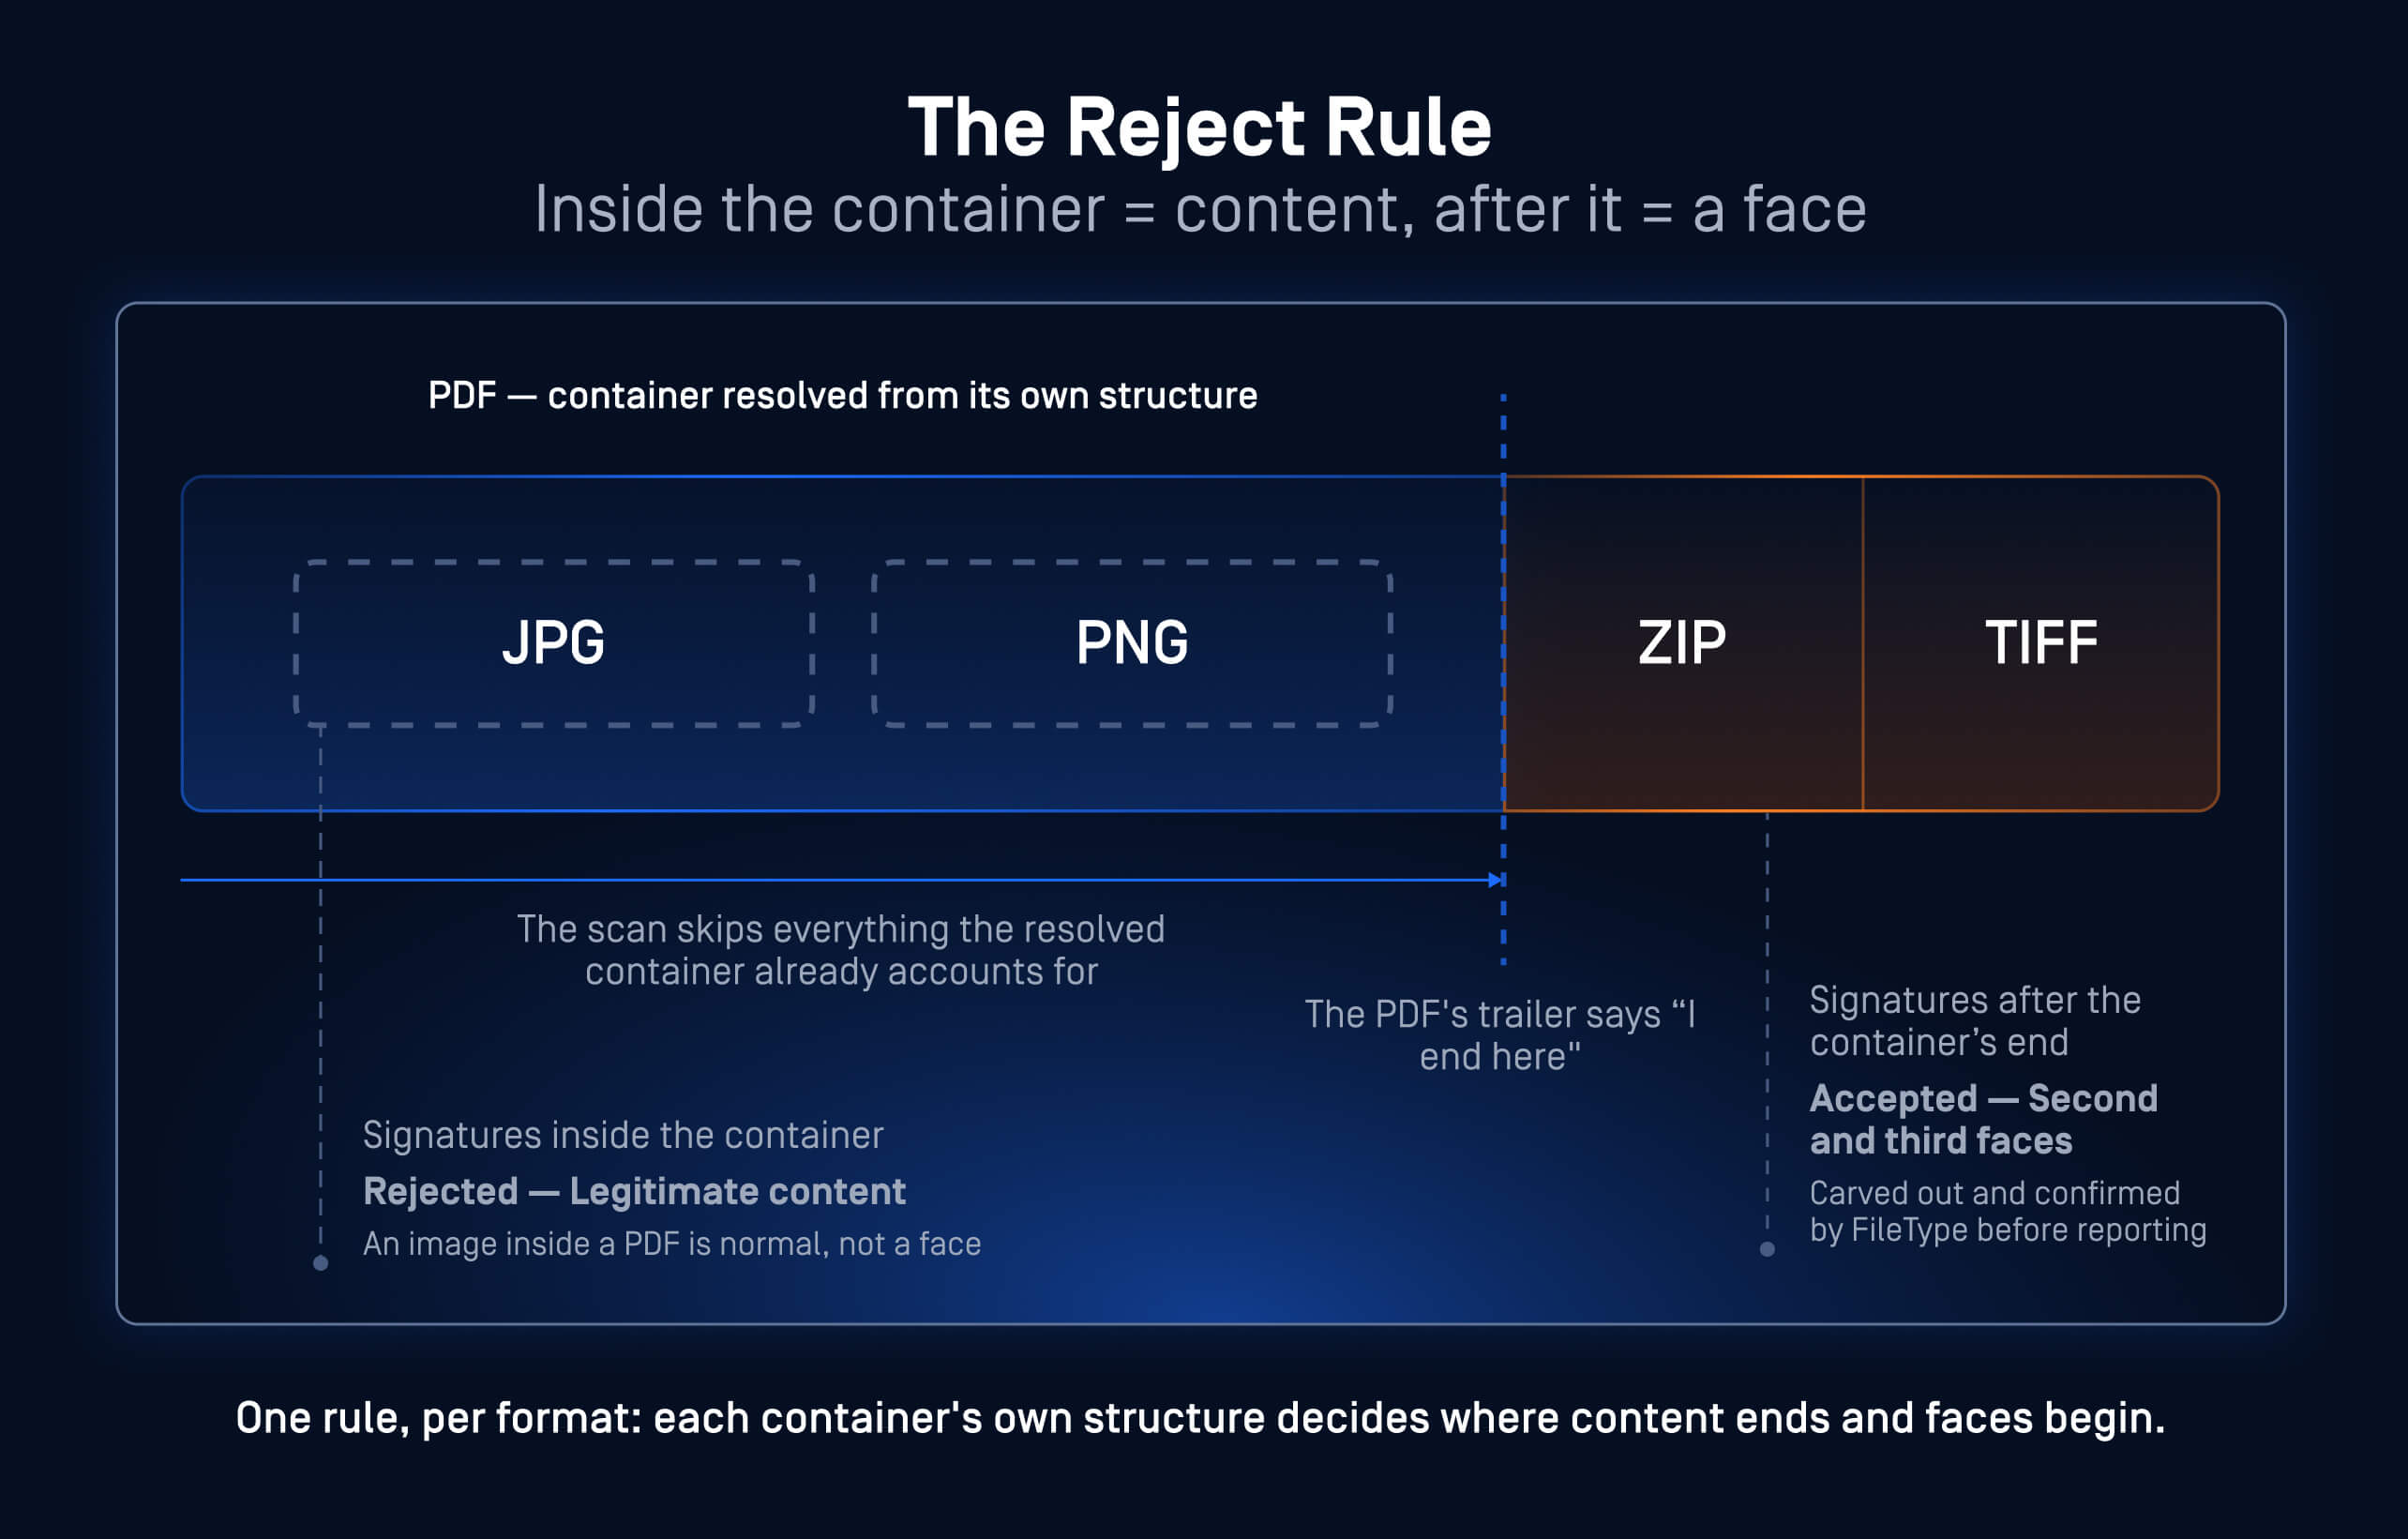
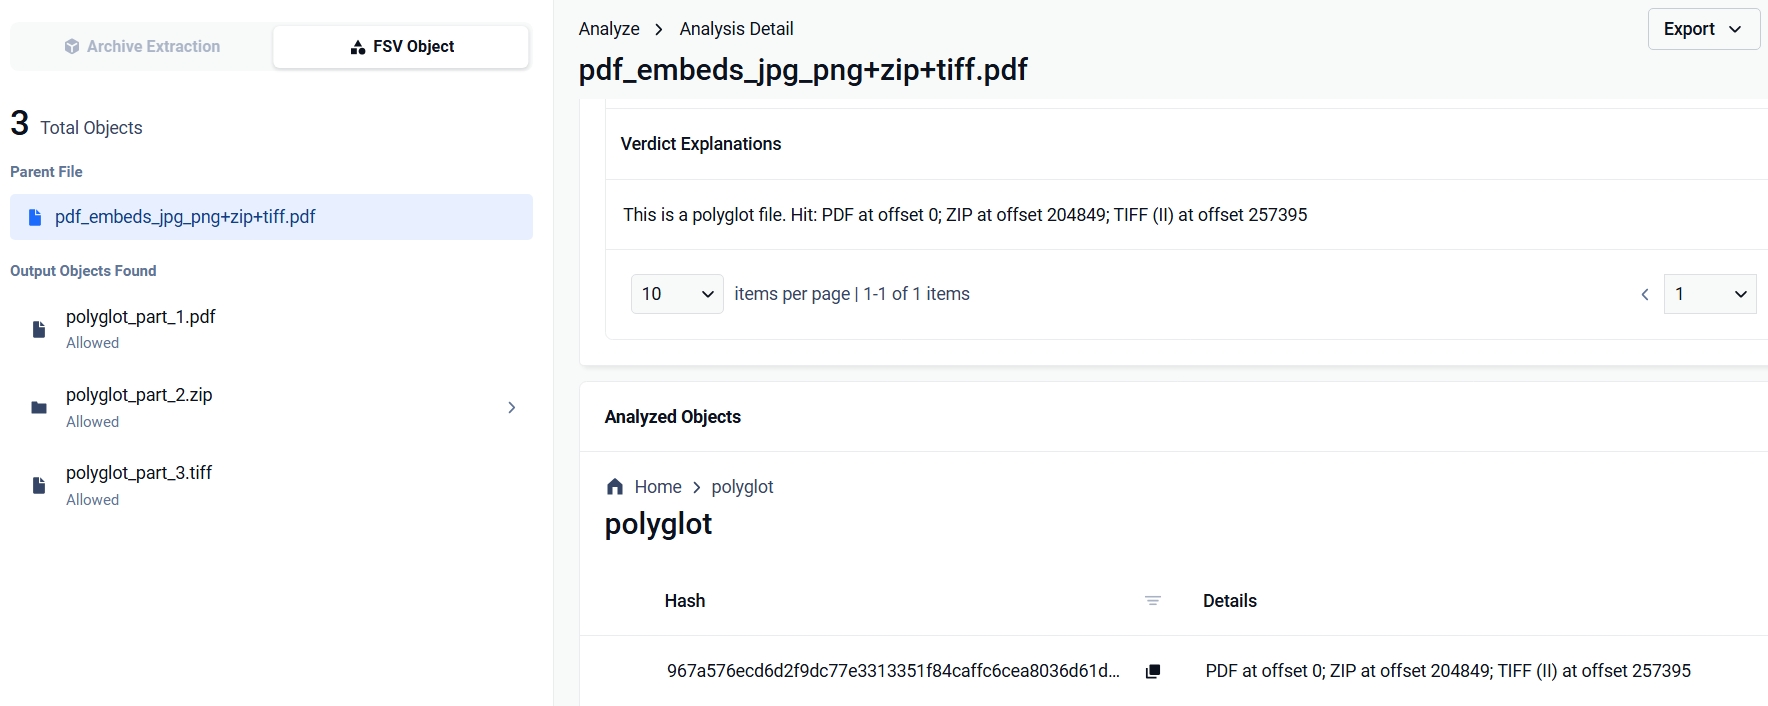
取自一个真实样本:一个PDF文件,其中嵌入了JPG和PNG图像,且在逻辑结尾之后还附加了一个ZIP文件和一个TIFF文件。检测结果指出了ZIP和TIFF文件,但对嵌入的图像未作说明。
结果会报告每个面及其偏移量。例如,上传的一个 .gif 文件会被识别为偏移量为 0 的 GIF89a,同时在数据流更深处被识别为 ZIP 压缩包。具体处理方式由策略决定:是报告该发现,还是直接拦截该文件并附上列出匹配项的说明。
从检测到解剖
检测只是解决问题的一半,因为“多面手”的诀窍在于,每个“面”单独看都无害。检测完成后,引擎会对文件进行拆解。每个被确认的“面”都会作为独立对象(如polyglot_part_1.pdf、polyglot_part_2.zip 等)导出,并附带其格式、偏移量和大小信息。引擎将每个“面”交还给MetaDefender Core™工作流,以便根据其真实性质进行全面处理。
我们在运行中的MetaDefender Core™实例上对此进行了端到端的验证。
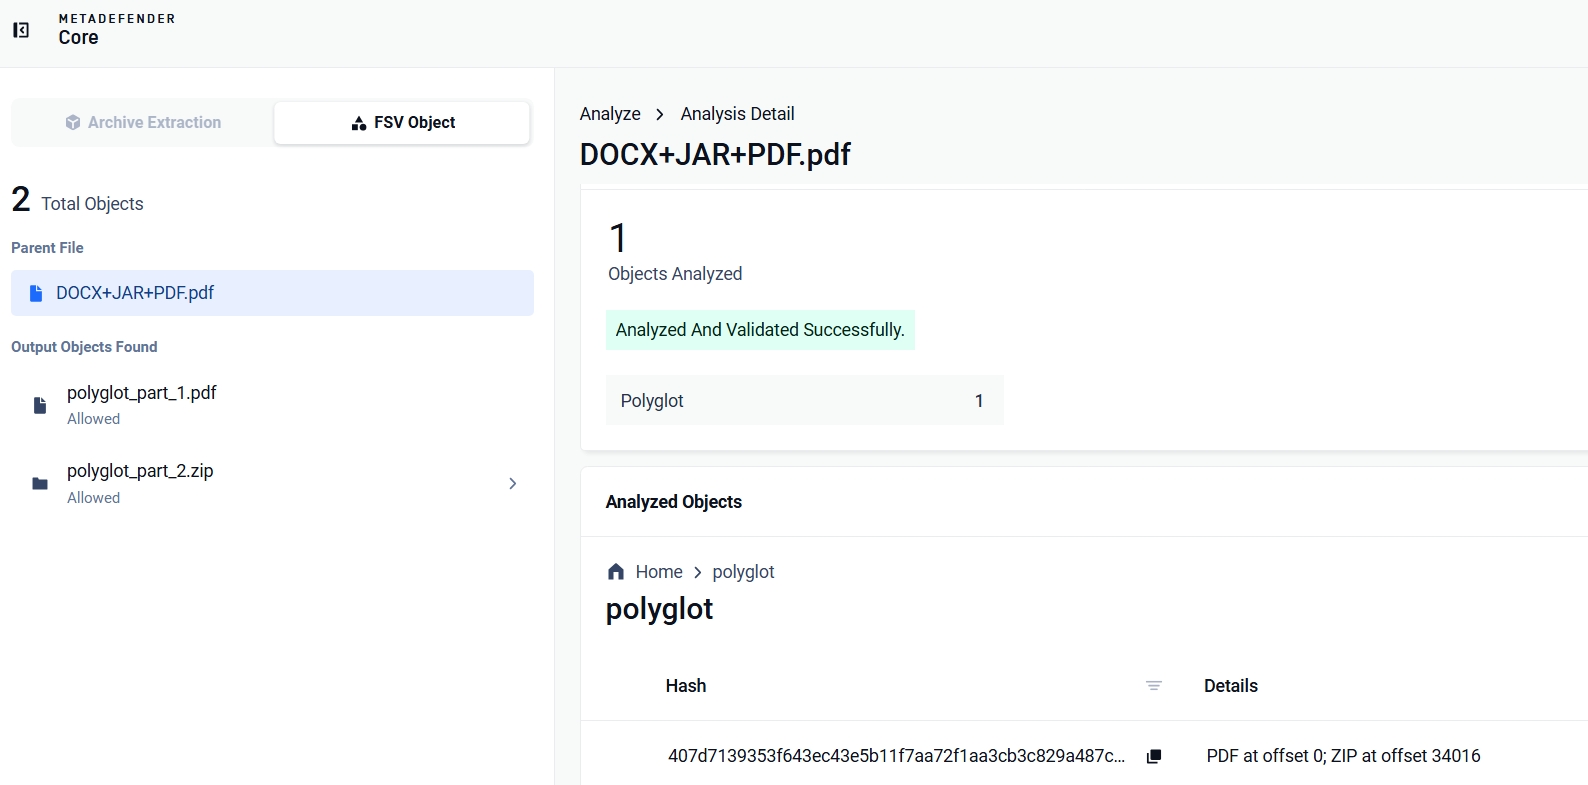
该引擎将一个秘密携带Word文档的PDF样本(一种PDF+JAR+DOCX多格式文件)拆分为其PDF层和ZIP层。由于JAR和DOCX都是ZIP容器,因此一个ZIP层即可满足这两项规范的要求。随后,文件类型引擎将该层识别为DOCX,并由Deep CDR™技术对其进行了单独清理。该隐藏层最终受到了与它原本试图规避的处理方式完全相同的处理。
精准才是难点
“魔术字节”在无害的文件中自然存在,因此真正的工程投入在于避免“狼来了”式的误报。相机照片中嵌入了带有自身JPEG签名的EXIF缩略图;Office文档在其容器结构中嵌入了图片;Media 文件中随机包含一些看起来像压缩头部的字节序列。 检测逻辑会排除已被合法结构所涵盖的字节,这种强化措施正以逐种格式的方式持续扩展。如果某个检测器会将每张相机照片都标记为可疑,那么它就会被关闭,而一个被关闭的检测器无法保护任何人。
经真正的多语者测试
我们将真实的多种语言样本输入到配备文件结构验证引擎的MetaDefender Core™生产环境中进行测试。所有样本均被成功检测出来,每个字符面都被精确定位到其对应的字节偏移量:
示例 | 找到的面(偏移量) | 成果 |
将Word文档隐藏在PDF中(将PDF、JAR和DOCX合并为一个文件) | PDF @ 0 · ZIP @ 34,016 | 已提取人脸;隐藏的 DOCX 文件已通过 Deep CDR™ 技术进行数据脱敏处理 |
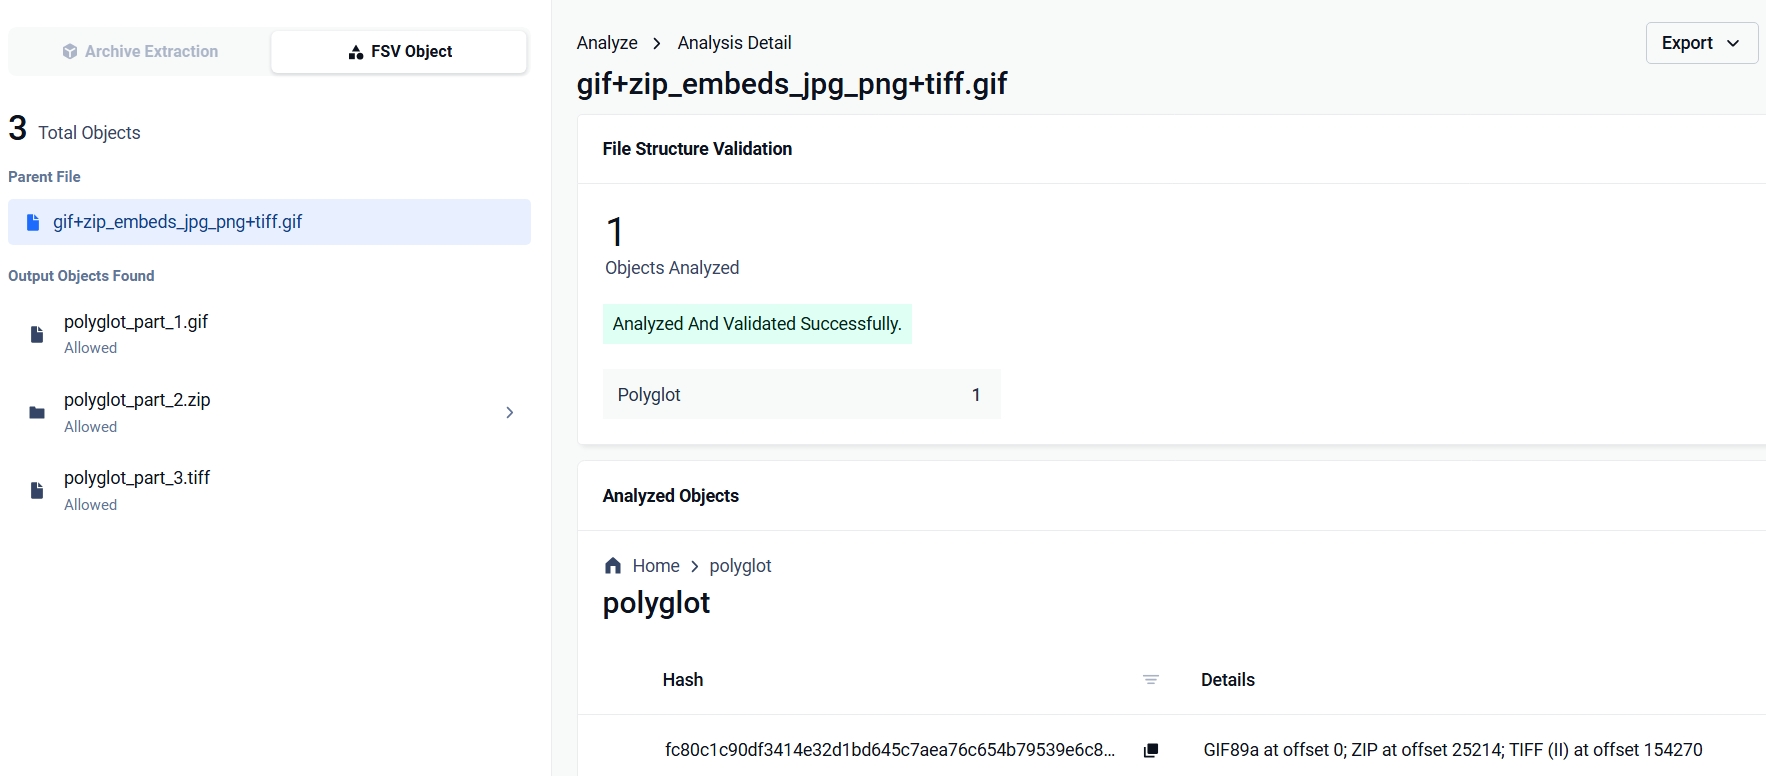
一个GIF中隐藏了一个压缩包和第二张图片 | GIF89a @ 0 · ZIP @ 25,214 · TIFF @ 154,270 | 已检测到 |
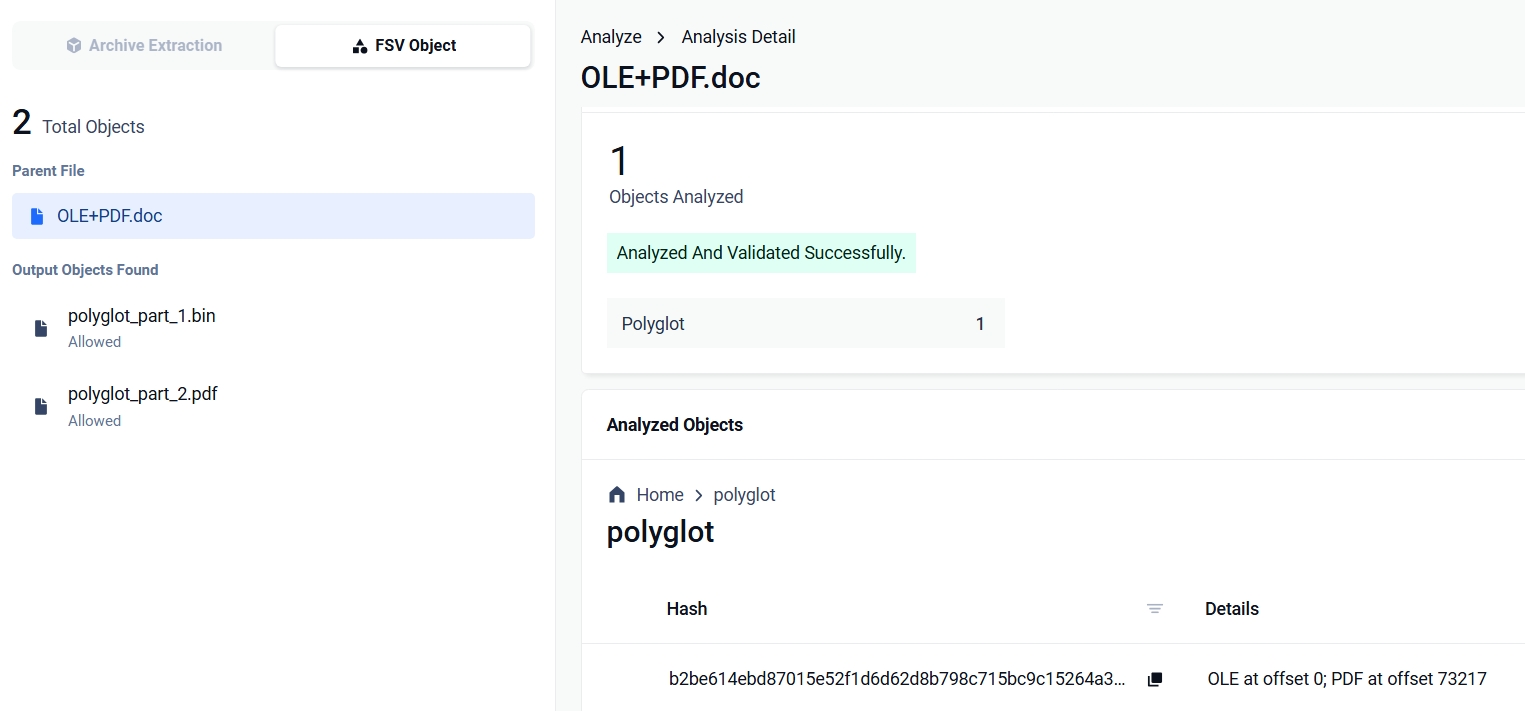
Office文档中隐藏的PDF文件 | OLE @ 0 · PDF @ 73,217 | 已检测到 |
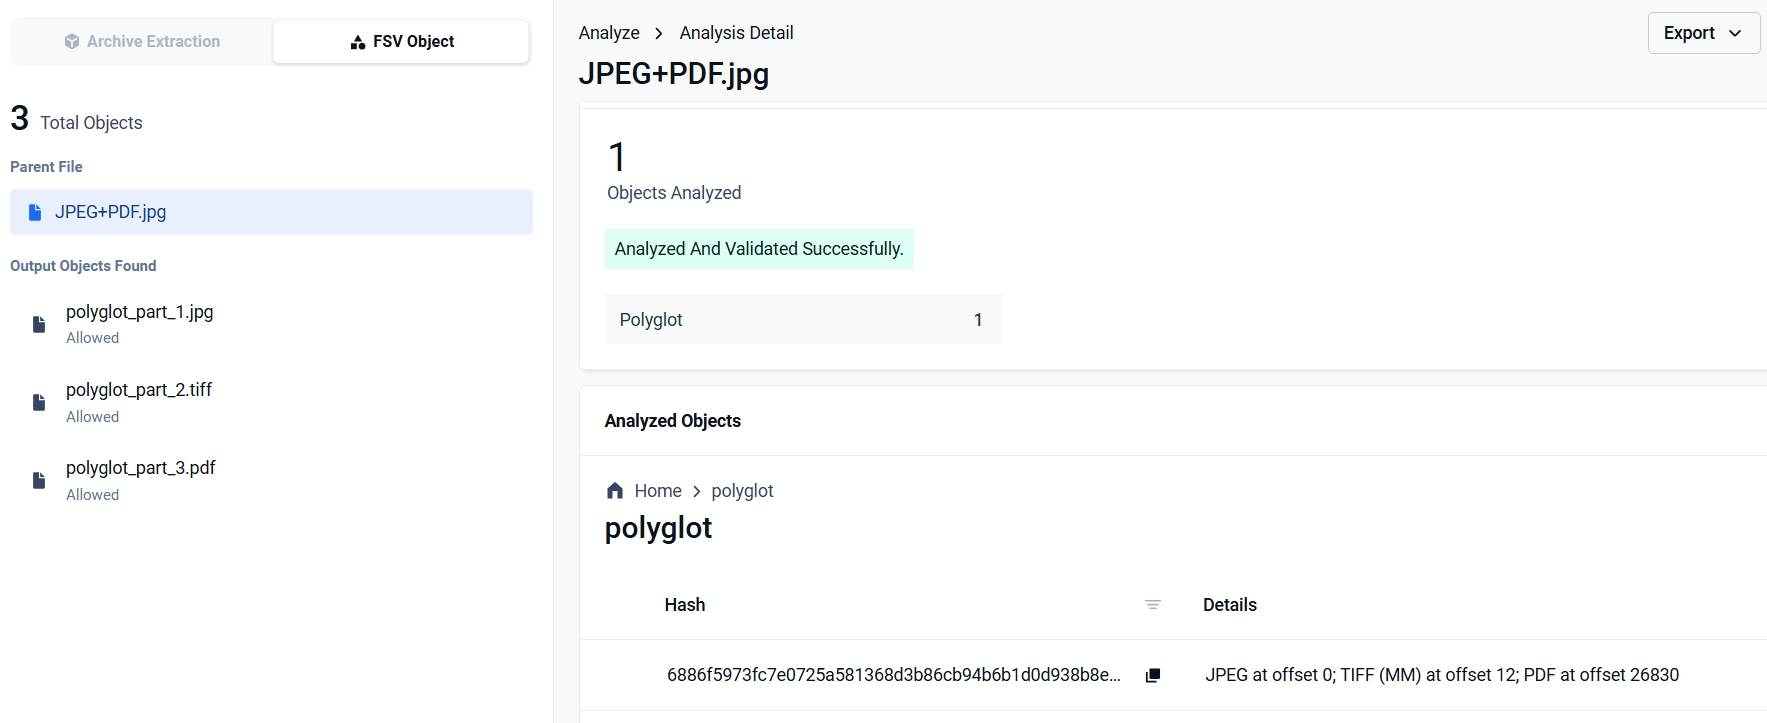
将PDF隐藏在JPEG中 | 三张脸,PDF 文件附后 @ 26,830 | 已检测到 |
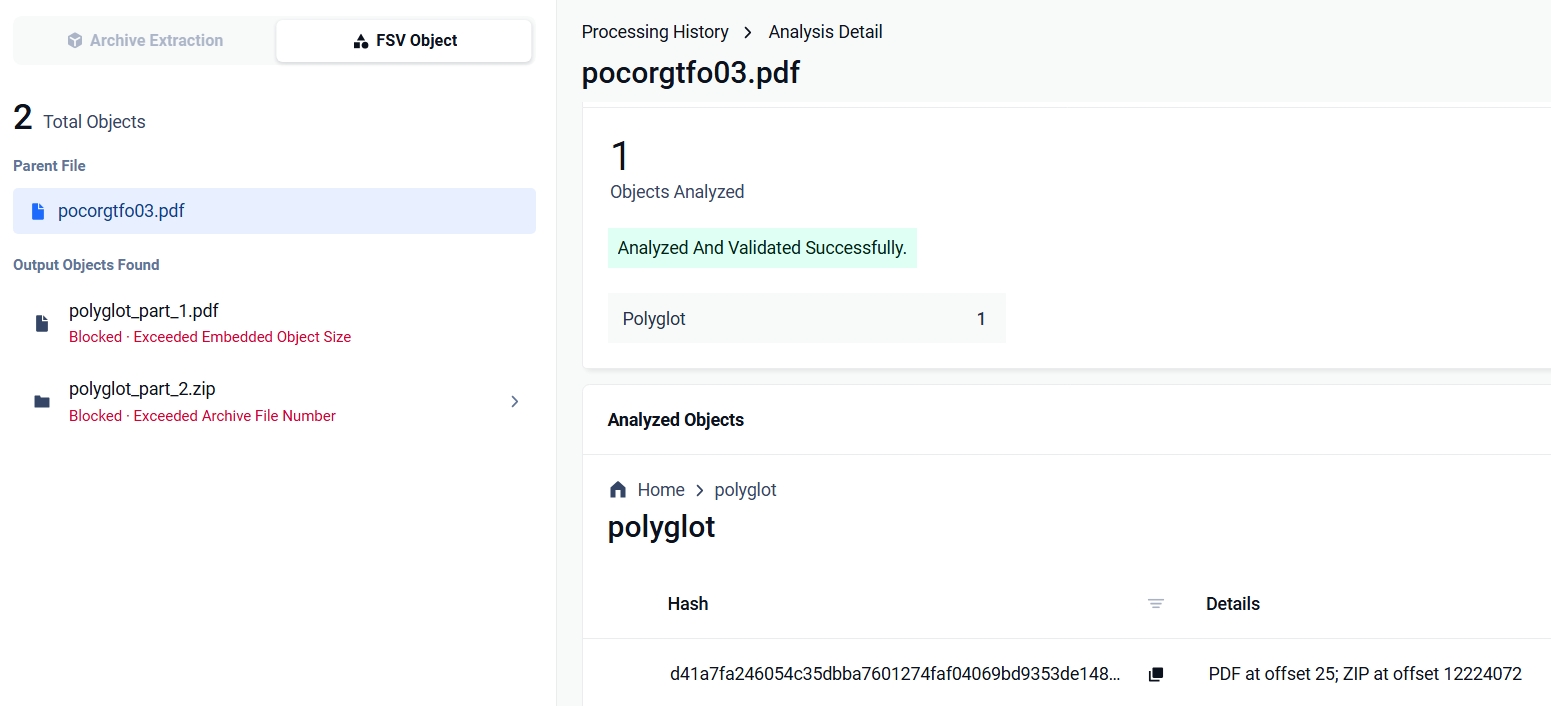
《PoC‖GTFO》第3期,这本安全研究杂志以PDF+ZIP多语言格式发布,大小为26 MB | PDF @ 25 · ZIP @ 12,224,072 | 检测到:通过全盘扫描在12 MB深度处发现第二个面 |
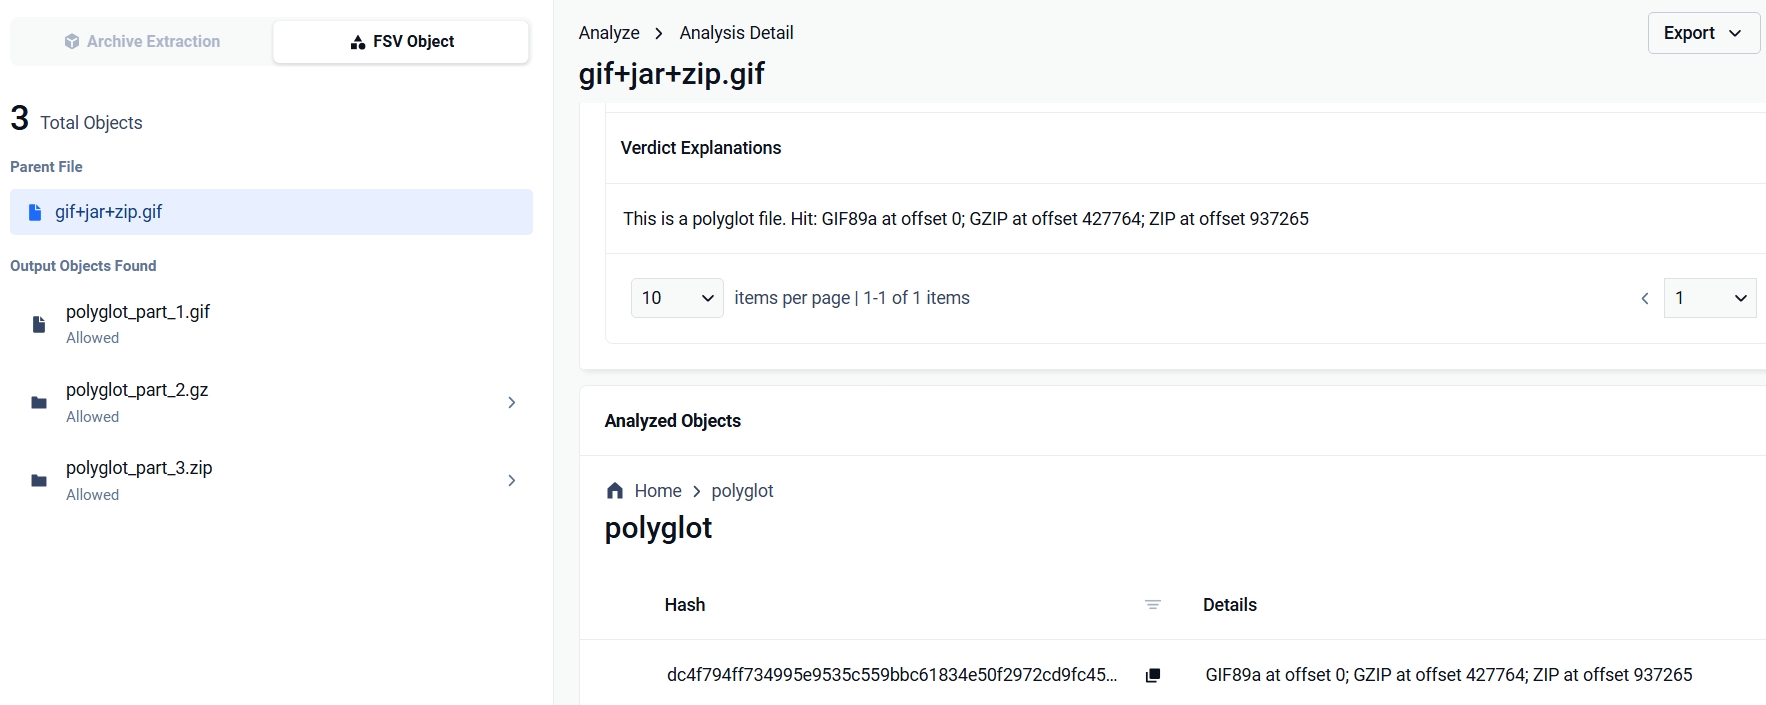
包含 GZIP 流和 Java 归档文件的 GIF 文件 | GIF89a @ 0 · GZIP @ 427,764 · ZIP @ 937,265 | 被屏蔽 |
PDF中嵌入了JPG和PNG文件,并附加了ZIP和TIFF文件 | PDF @ 0 · ZIP @ 204,849 · TIFF @ 257,395 | 被屏蔽;嵌入的图片未被正确报告 |
最后一行为“拒绝规则”的实际应用:判定结果指明了附加的 ZIP 和 TIFF 文件,并忽略了 PDF 中的图片。容器解析器将这些图片视为 PDF 自身的内容。MetaDefender Core™ 针对该文件生成的结果 JSON(节选):
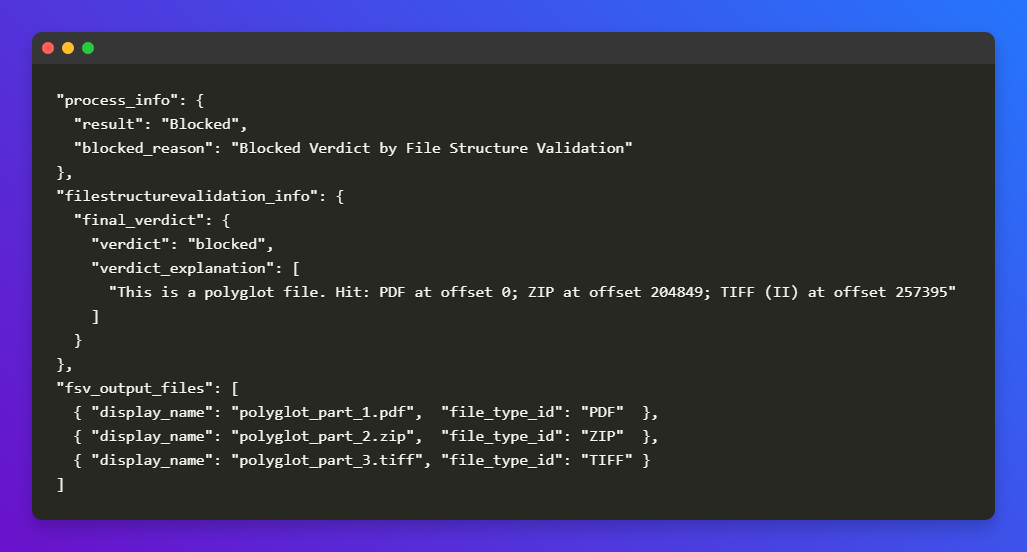
fsv_output_files列表就是上文所述的“解剖”过程,即:将三个面切出并作为独立对象交还给工作流。
以下是MetaDefender Core™中每个示例结果的屏幕截图:
覆盖范围与配置
本文涵盖了攻击者实际组合使用的文件格式:PDF、ZIP、OLE 复合文件、PNG、GIF、JPEG、TIFF、RAR、GZIP 和 7z。
结构化容器末端解析功能适用于各类容器格式。该功能采用“配置优先”的实现方式:检测、拦截和全文件扫描均作为策略开关,因此运维人员可根据具体部署情况,在可见性与强制执行之间进行选择。
底线
一个包含两个有效面的文件会使任何将其分配为单一类型的处理流程失效,而单一类型检测正是大多数扫描堆栈的基础。结构化多类型检测通过查找所有面并验证每个面都能被解析,从而弥补了这一缺陷。随后,策略可以在任何应用程序选择错误的解释器之前阻止该文件。
目前已支持对常见攻击格式的检测。针对其余归档格式的容器末尾解析功能已列入路线图。
了解“文件结构验证”功能如何处理流经您环境的各种文件格式。